AI下棋简史:从9吨重的IBM 704,到没看过人类棋谱的AlphaZero

2015年,我在上海创业。有一次和CTO闲聊,我说我之所以喜欢下围棋,是因为在这件事上,计算机永远赢不了人类。

这句话说完刚好一年,AlphaGo来了。

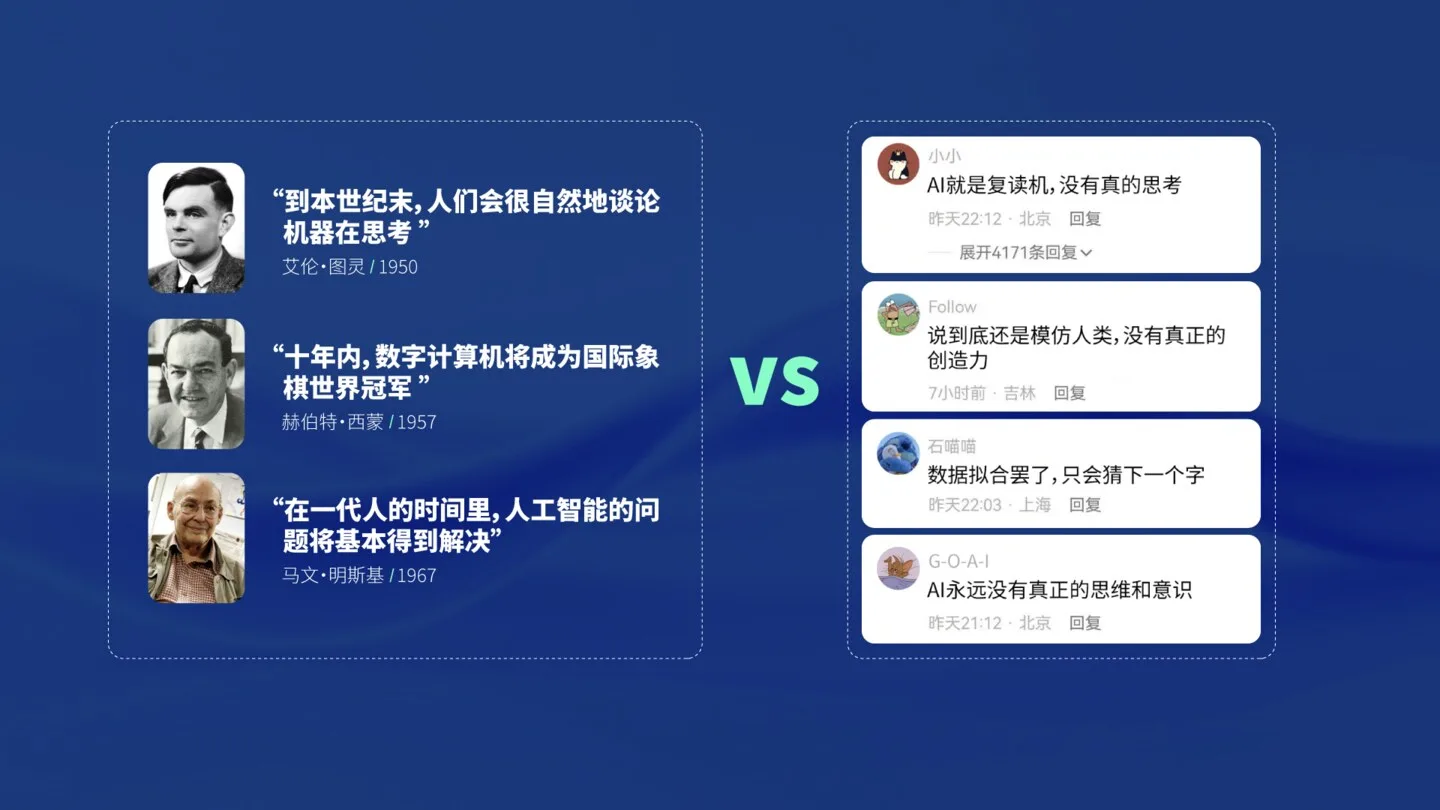
一年多以前,我在很多人身上,看到了当年我自己的那种笃定,只不过对象换成了大模型。那时流行的说法是:大模型不过是读遍了人类的文字,再去预测下一个字。既然是在模仿人类,它给出的答案注定平庸,搞不出真正有创意的东西。再加上训练语料快用完了,scaling law被认为已经见顶,芯片又被卡着脖子,AI的故事好像讲到头了。

这一次,我站在了另一边。经历过AlphaGo,我对这类判断早就有了不同的看法:今天关于大模型的这场争论,答案十年前就在棋盘上演过一遍了。

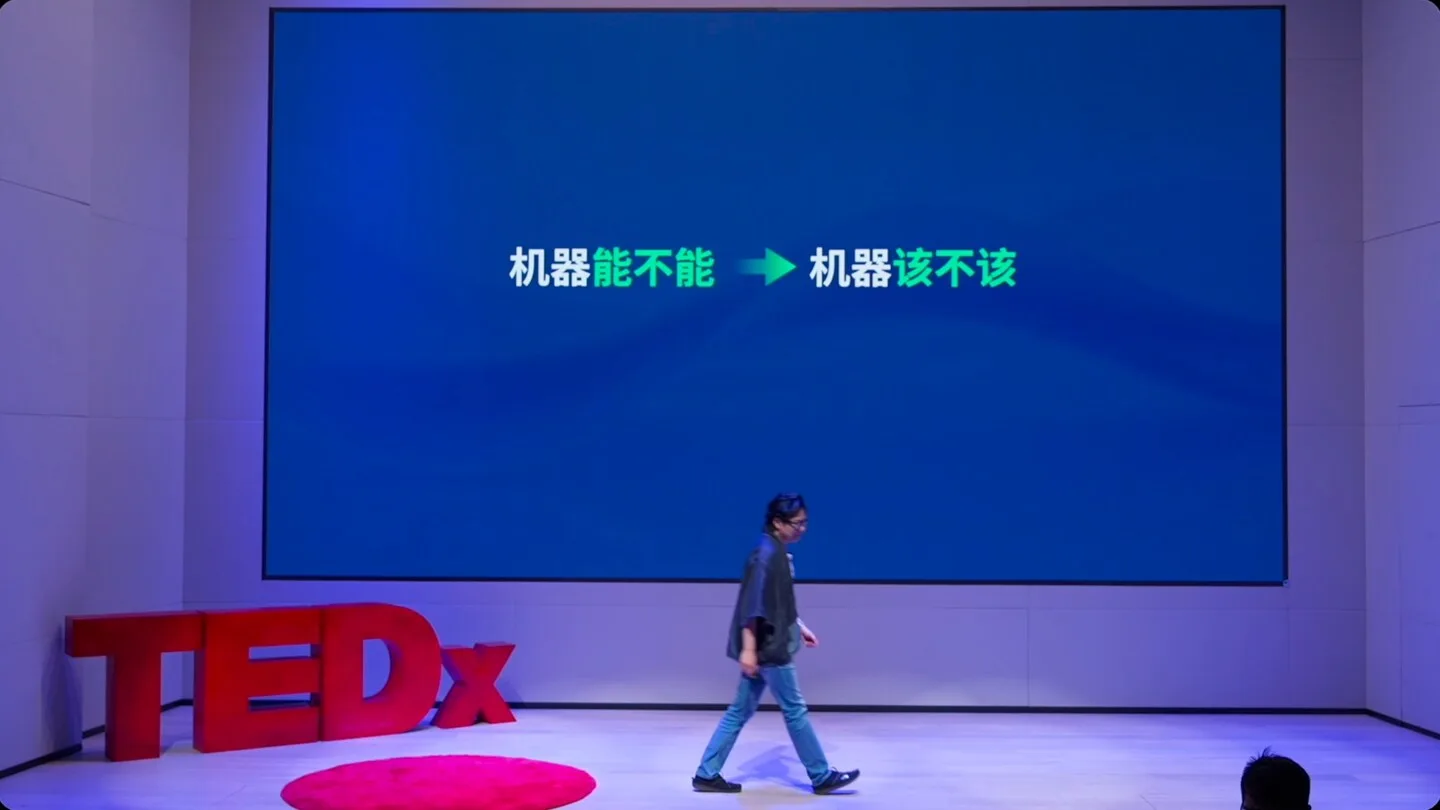
一年多前,我做了一场TEDx演讲,题目叫《AI能否超越人类的直觉和创造力》,想说的就是这件事。只是演讲没有直接谈大模型,讲的是一段更老的历史:计算机下棋,从1958年的IBM 704,一路讲到2020年的MuZero。
然后就是这一年。AI在编程和数学上接连突破。9月,OpenAI宣布,它的内部模型给千禧年大奖难题之一的纳维-斯托克斯方程交出了一份证明:在某些条件下,这个描述流体运动的方程会在有限时间内「崩溃」。10月,它又一口气公开了几百份论文,声称解决了三百多个悬而未决的数学问题。放在一年多以前,这简直是天方夜谭。

到今天,「AI只会预测下一个字」这句话,已经站不住了。那场演讲时间有限,很多地方没来得及展开,正好借这篇文章,把它完整地讲一遍。

01 把人类的经验,硬写进代码

人工智能刚诞生的时候,先驱们普遍很乐观。1958年,赫伯特·西蒙等人预言:十年之内,计算机将成为国际象棋世界冠军。

这件事最后用了四十年。
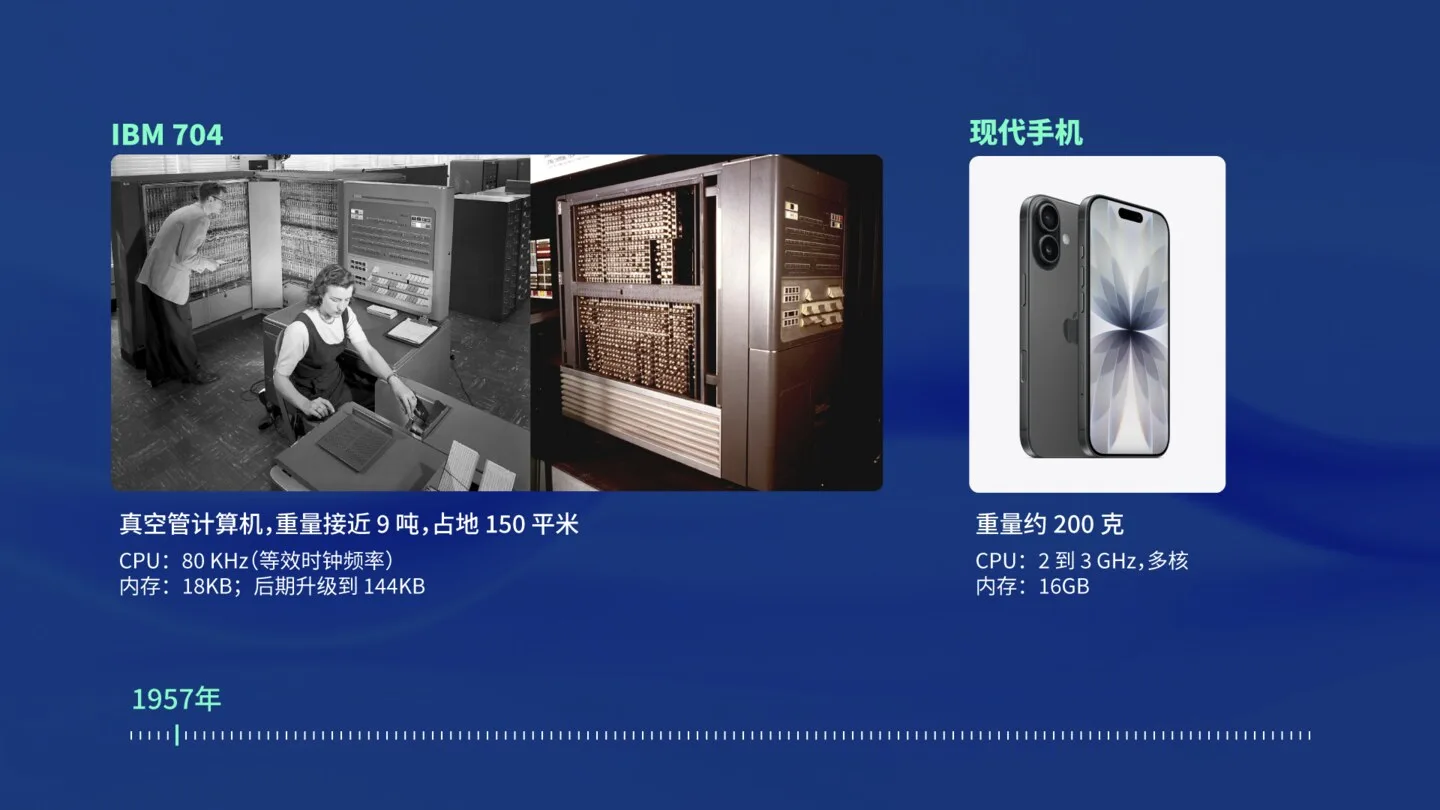
同样是1958年,伯恩斯坦等人发表了一篇划时代的论文,让计算机第一次完整地下了一盘国际象棋。他们用的是IBM 704,当时最强的计算平台:真空管电子计算机,重近九吨,占地一百五十平方米,速度却不到今天一部手机的百万分之一。

在这台又大又笨的机器上,程序的逻辑非常朴素。每个棋子有固定价值,皇后9分、车5分、马3分。决策分成八个优先级:被将军了先解将,再看能不能吃子、会不会丢子,实在没事干就随便走一步。每一步只挑7个候选点,每个点往前算4步,也就是7的4次方,2401个局面。

计算量其实很小,但704太慢了,每走一步要等八分钟左右。下出来的水平,大概相当于人类的业余初学者:开局中局还像模像样,一到残局就露馅,因为它根本没有复杂的残局逻辑。

这就是把人类下棋的经验,硬生生写进代码。写出来的,只是一个初学者。

但这篇论文奠定了电脑下棋的基本框架。之后几十年,所有进步都沿着这个框架,从三个方向推进:

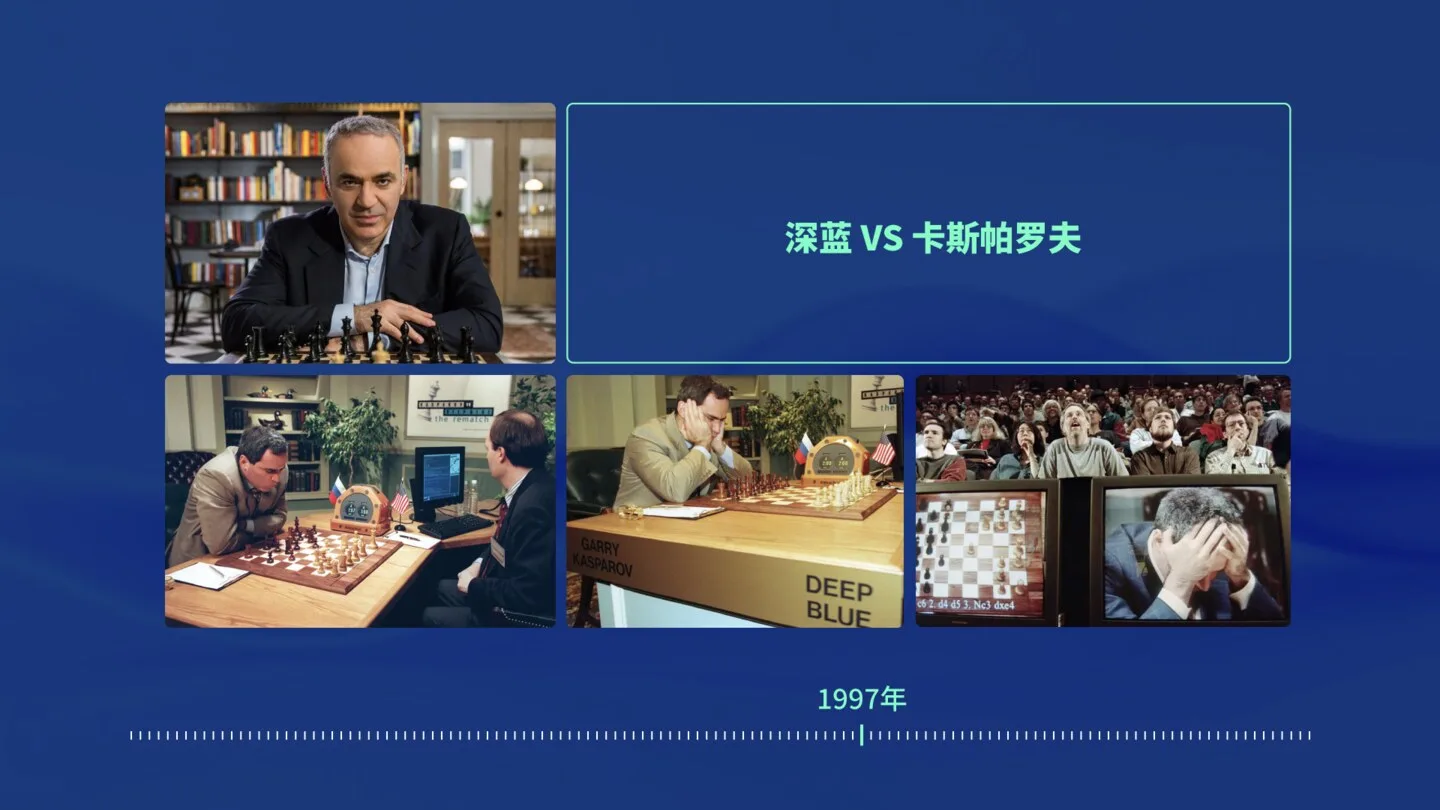
1997年,这条路走到了巅峰:IBM的深蓝战胜了国际象棋世界冠军卡斯帕罗夫。

深蓝是当时全球排名第259位的超级计算机,装了480枚专门为下棋设计的芯片,里面塞满了极其复杂的人工评估规则和调参,加上庞大的开局库和残局库(当时是完整的五子残局库和部分六子残局库,七子残局库要到2012年才建成)。

这是人类智慧和机械计算共同创造的巅峰时刻。但巅峰也意味着到顶了:靠人类知识加蛮力计算,有一样东西,计算机永远拿不下。

那就是围棋。

02 围棋这堵墙,墙在哪里

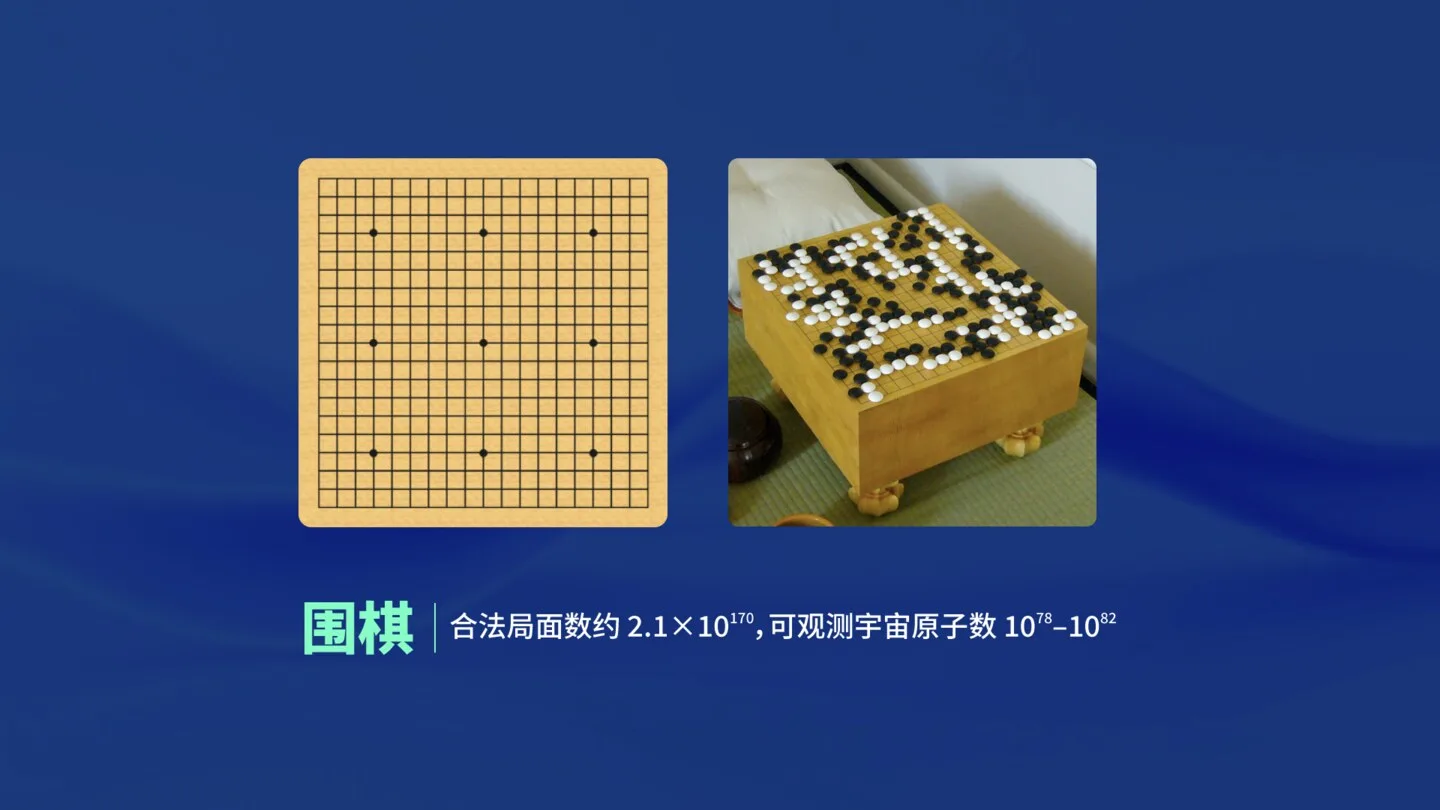
说到围棋为什么难,网上最流行的说法是:围棋的变化数超过了宇宙中原子的总数。我当年在演讲里也是这么说的。

但这其实不是关键。国际象棋的博弈树虽然比围棋小得多,也同样远远超过宇宙原子数。两种棋都「算不完」,深蓝照样赢了。

围棋真正难的地方,是写不出一个评估函数。

国际象棋判断局势,数一数子力就能大致看出谁占优,伯恩斯坦1958年就是这么做的。可围棋只有黑子和白子,每颗子都一样,你没法说这颗比那颗值钱。下到中盘,到底谁领先,有时候连职业棋手都说不清楚。

那人类是怎么下围棋的?靠的不是计算,是棋感。

下棋的人常说「我的第一感是哪里」。高手看一眼棋盘,就能直接锁定最可能的几个选点,根本不需要把每个点都算一遍。在这个意义上,围棋是一门直觉的艺术。

心理学家Chase和Simon做过一个经典实验:让国际象棋大师看一个真实对局的棋盘,只看五秒钟,然后让他摆回来,他能摆得八九不离十。但如果棋子是随机摆放的,大师的记忆力就和新手差不多。

围棋也一样。很多人好奇职业棋手怎么能记住那么长的棋谱,原因是每一步都有逻辑、有直觉在里面。换成一个随机棋谱,高手也背不下来。高手记住的不是一颗颗棋子,而是模式。

而识别图像中的模式,恰恰是神经网络最擅长的事。

于是问题来了:直觉,真的是人类独有的天赋吗?

03 AlphaGo:机器学会了「第一感」

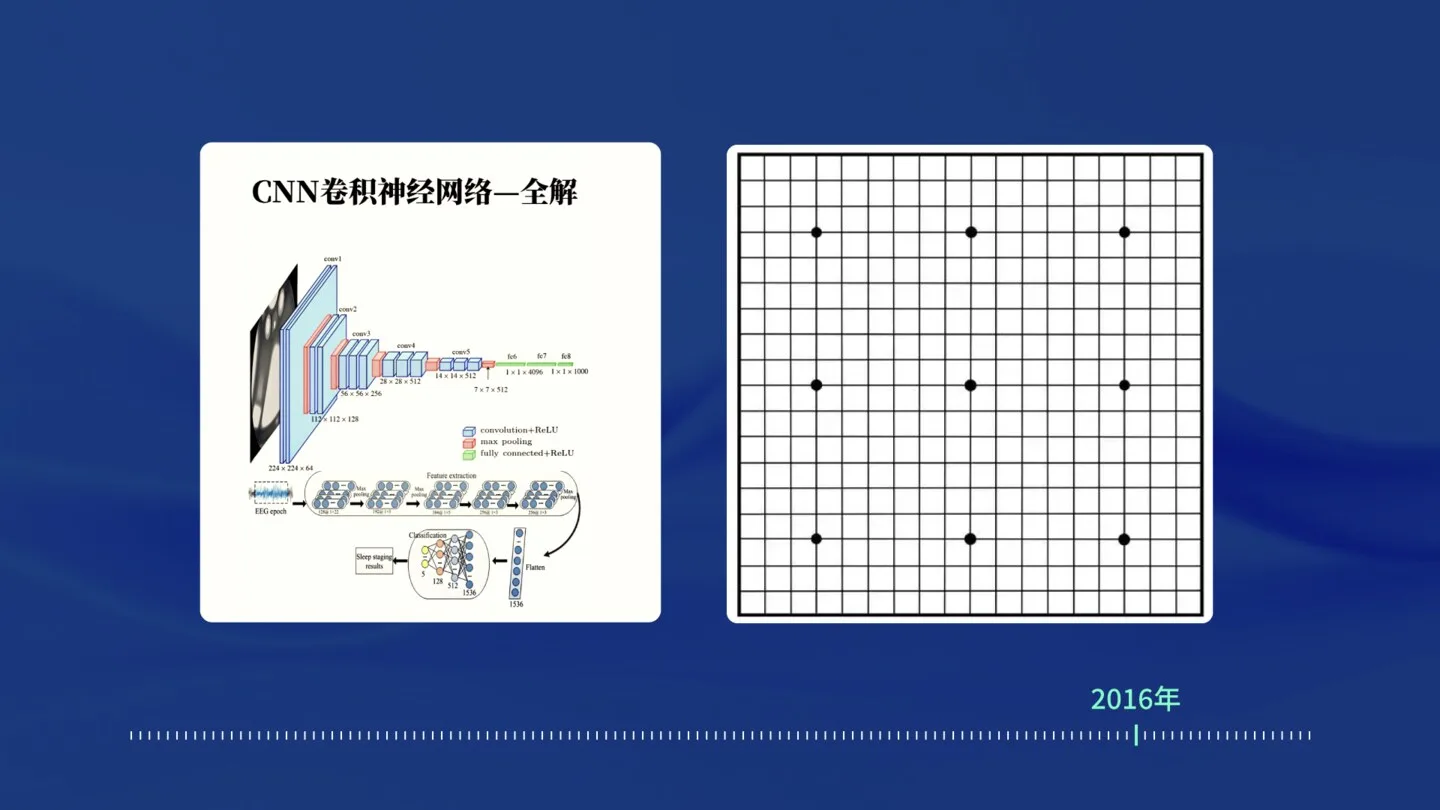
到2015年前后,卷积神经网络已经能很好地处理224×224甚至更大的图片了。从计算的角度看,围棋复杂得吓人;但换个角度,一张19×19的棋盘,不就是一张很小的图吗?

一个天才的想法出现了:让AI把围棋当成图片来看。

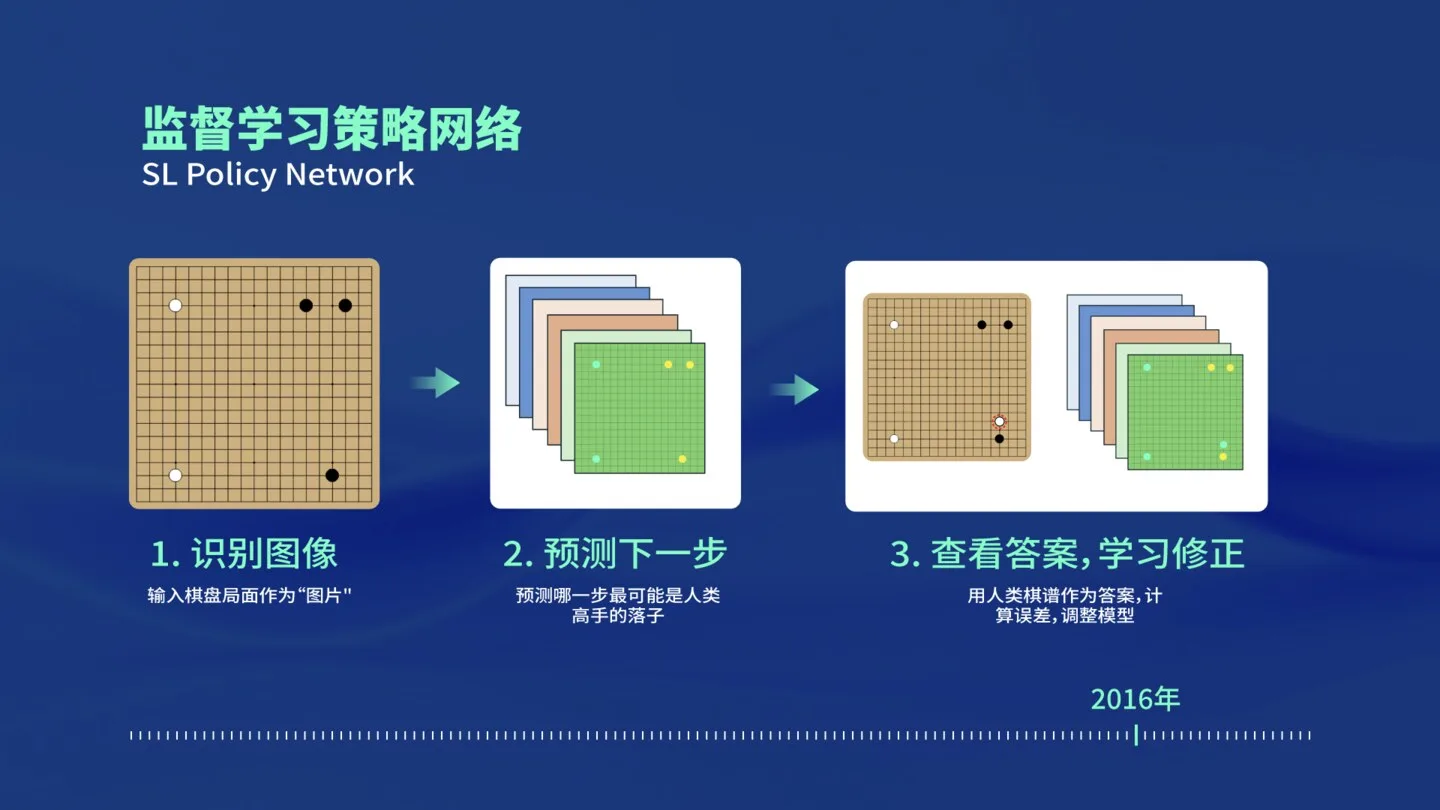
普通图片有RGB三个通道,输入网络的是三张叠在一起的图。AlphaGo的团队给围棋设计了48个通道:黑子一张、白子一张,还有专门表示「气」的、表示落子后能提掉几颗子的、表示征子的……这48个通道里,装的全是人类对围棋的理解。最后输入网络的,是一张19×19×48的「图」。

训练数据来自海外围棋平台KGS上6到9段(平台段位,不是职业段位)的16万盘对局,拆成大约3000万个局面。注意,这不是最强人类棋手的棋谱,而是业余高手的。

AlphaGo用一个13层的卷积网络,看一眼棋盘,预测人类棋手下一步会落在哪里,准确率达到57%。这就是它的监督学习策略网络。

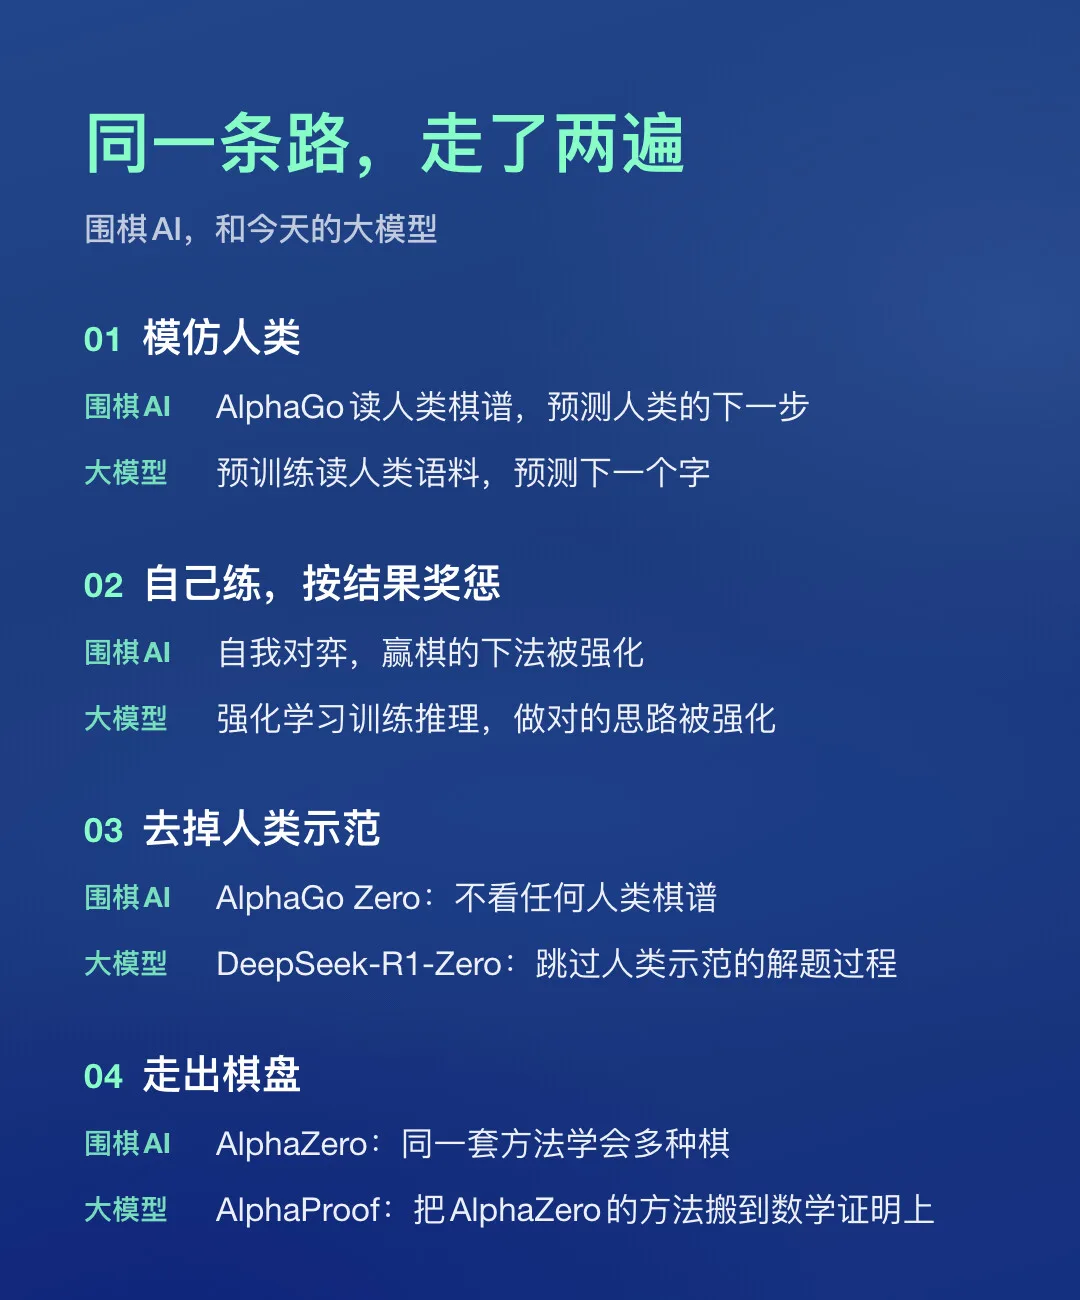
看到这里,你有没有觉得眼熟?看人类的棋谱,预测人类的下一步。这和「读人类的语料,预测下一个字」,几乎是同一件事。 这一点先记住,后面会回来。

但只靠模仿,AI永远赢不了顶尖的人类。就算预测准确率到了100%,它也只是一个KGS上的业余高手。

于是AlphaGo开始自己跟自己下。50块GPU,海量对局,每盘棋奖励赢的一方、惩罚输的一方,赢棋的下法以后被选中的概率就更高。这是强化学习策略网络。从这一步开始,AI不再只是模仿人类,而是形成了自己的偏好。

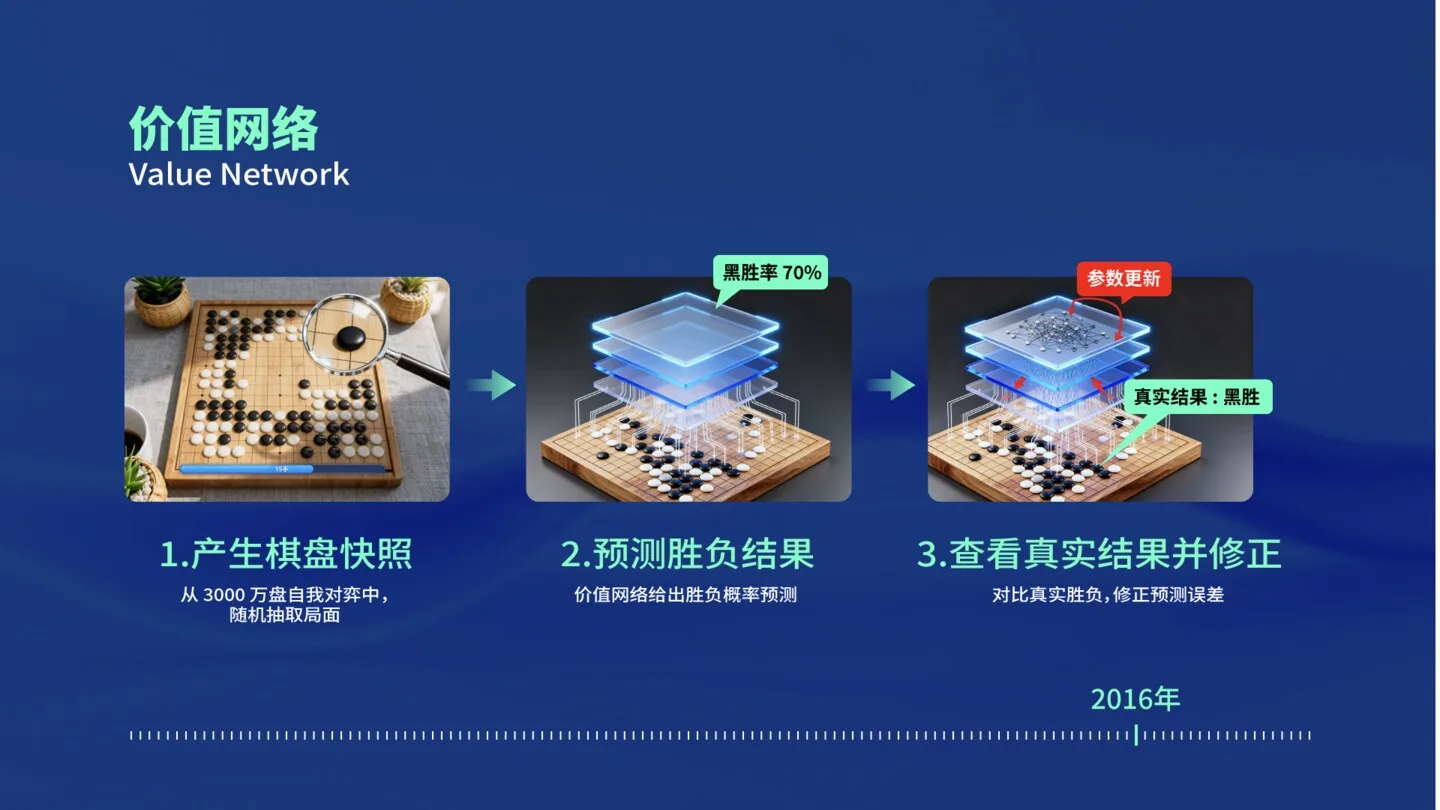
接下来更妙。用这个已经变强的网络再下3000万盘棋,每盘只随机截取一个局面,结局是谁赢早就知道。训练时先不告诉AI答案,只让它看这一个局面,直接判断谁会赢,再拿真实结局去纠正它。

练完之后,AI看一眼棋盘,不用一步步往下推演,就能说出这盘棋的胜率。这是价值网络。在「判断局势」这件人类觉得只能靠棋感的事情上,AI也有了直觉。

最后,AlphaGo再配上一个下得快但比较粗糙的「快棋手」,短时间内模拟成千上万盘棋直到终局,作为价值网络的补充;用蒙特卡洛树搜索把这些整合在一起。直觉和计算相辅相成,这和人类高手下棋的方式非常像。

2016年3月,AlphaGo以4比1战胜李世石。

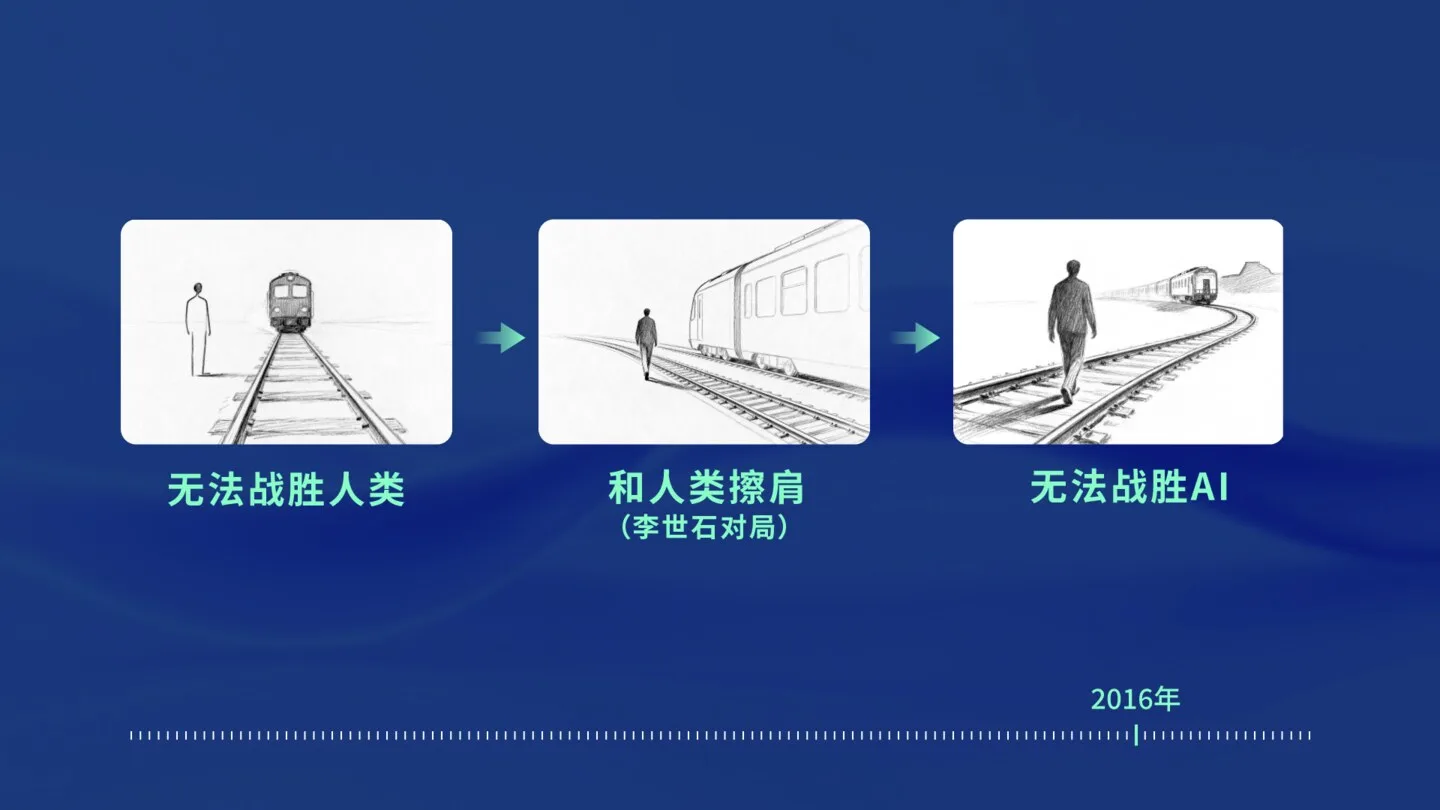
我一直觉得,人工智能像一列呼啸而来的火车。它在远处的时候,你根本不信它会来,就像2015年的我。然后它在站台上和人类擦肩而过,那就是2016年的李世石。再然后,它飞速远去,人类再也没有追上的机会。

2016年底到2017年初,一个叫Master的神秘账号在网上横扫中日韩高手,取得60连胜,古力甚至悬赏10万元找能赢它的人。后来大家才知道,那是新版的AlphaGo。2017年5月,它对阵柯洁,柯洁没有任何机会。按照DeepMind公布的等级分换算,对阵李世石的那个版本,如果和对阵柯洁的这个版本下,胜率只有0.16%左右。

2019年,李世石宣布退役,理由之一就是AI。一个棋手即便成为世界第一,头上也永远有一个赢不了的对手。更难受的是,一步棋下得好不好,现在由AI说了算,世界第一也没有了话语权。

AlphaGo告诉了我们两件事。第一,AI可以拥有下棋的直觉。第二,AI的上限,并不取决于它学到的人类资料。 它学的只是业余高手的棋,最后却碾压了顶尖职业棋手。

04 人类教得越少,AI反而越强

2017年10月,和柯洁那场比赛之后五个月,AlphaGo Zero发表了。论文标题叫 Mastering the game of Go without human knowledge,不依赖人类知识,学会下围棋。

我第一次看到这个标题,是感到有点可怕的。

前面说过,AlphaGo的48个输入通道里装满了人类的围棋知识,某种程度上,是人类在手把手教AI这个棋盘该怎么看。而AlphaGo Zero的输入只有黑白子的位置,加上最近8步的历史(因为处理打劫需要知道之前下过什么,这是规则本身的要求),一共17个通道。负责计算的快棋手也去掉了,架构简洁得多。它不看任何人类棋谱,从零开始自己摸索。

结果呢?只用神经网络、完全不做前瞻搜索,也就是只凭「第一感」落子,它的等级分就到了3055,已经是职业棋手的水准。加上搜索之后,是5185,一个超人的数字。

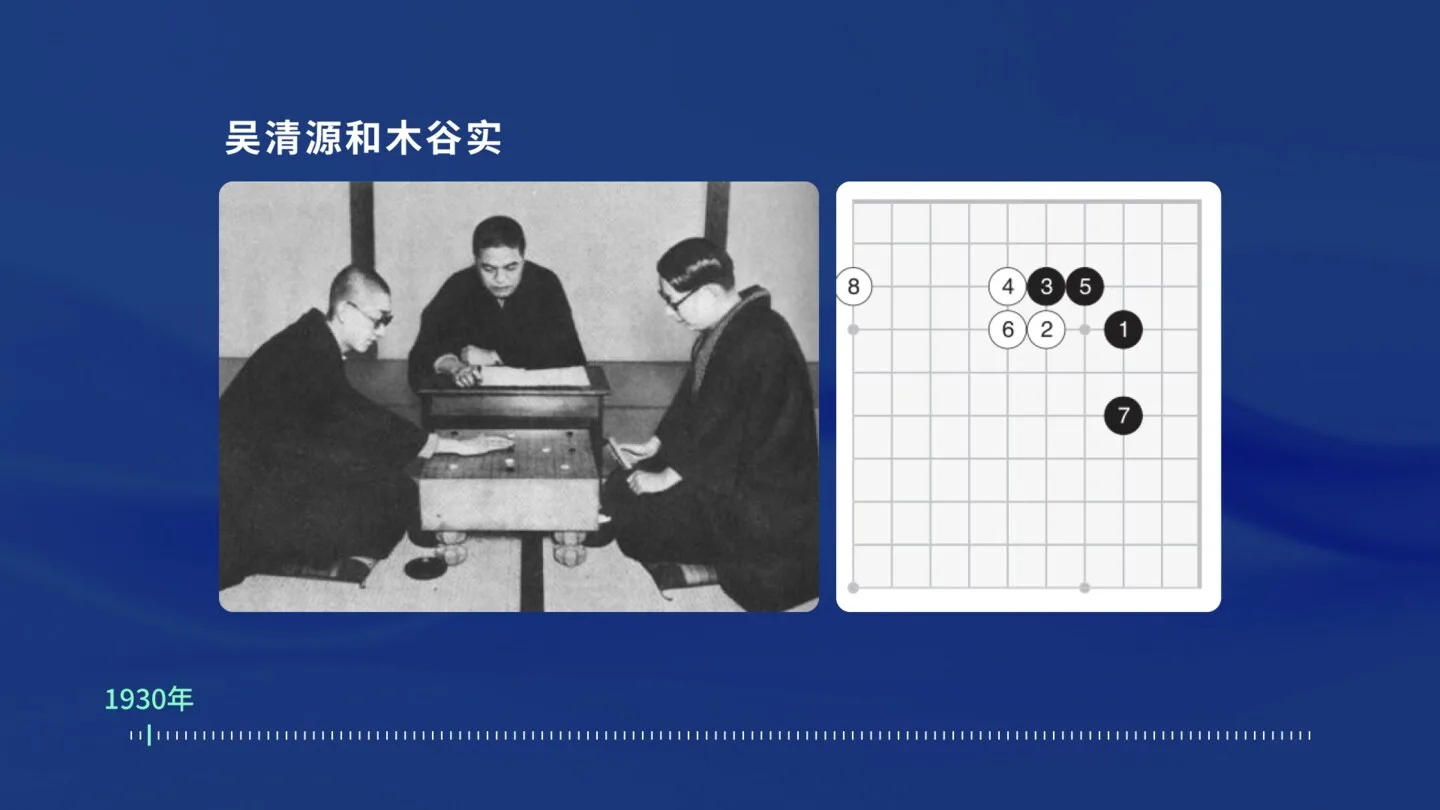
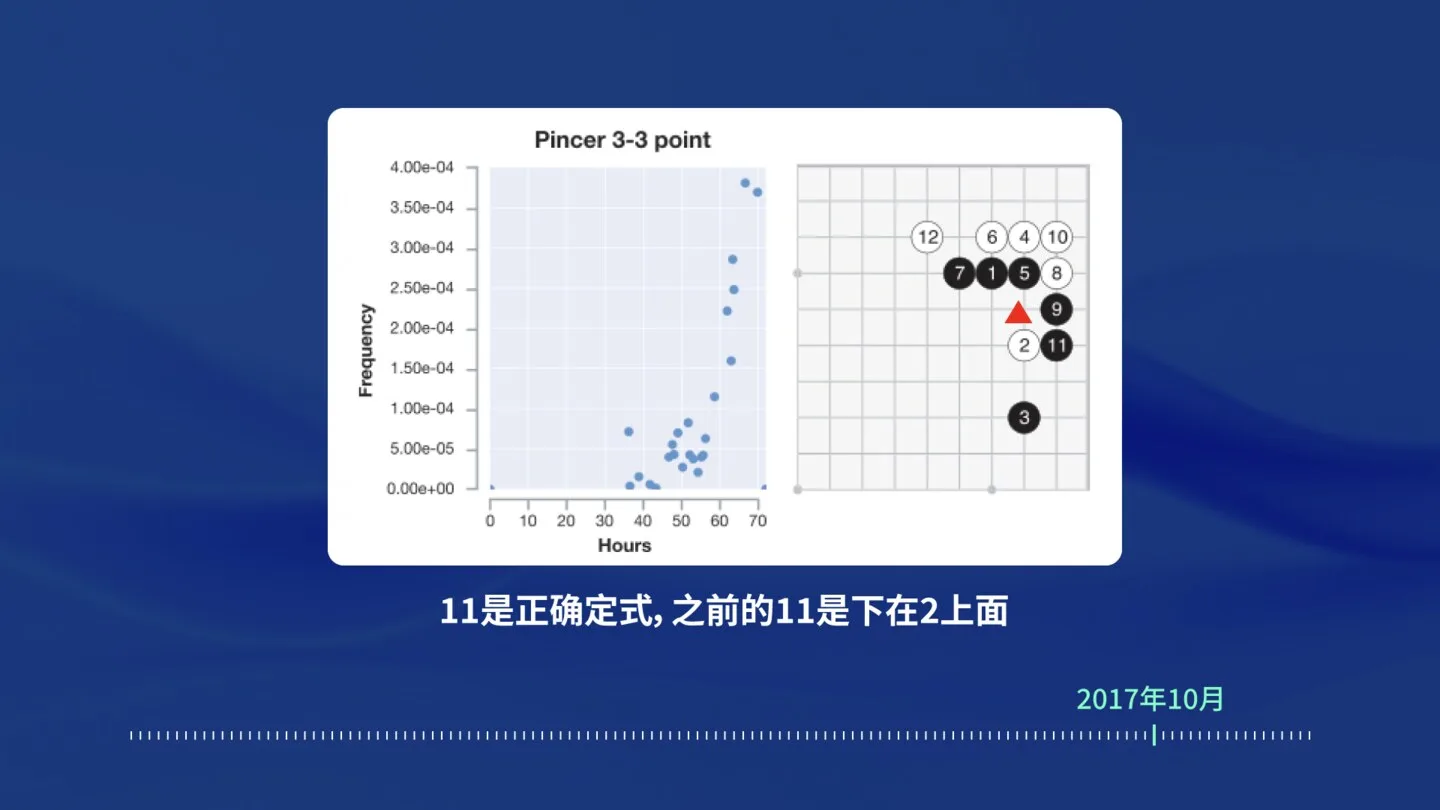
人类下了两千多年围棋,理论一代代往前推。1930年代,吴清源和木谷实掀起新布局革命,小目托退的下法因为木谷实下得多,被叫作木谷定式。AlphaGo Zero从完全不懂围棋开始,不到二十个小时就自己重新发现了它。

更有意思的是,一些久经考验的人类定式被它发现之后,很快又被它否定了。我当年学棋时,某个定式里黑11就下在一个固定位置,AI告诉我们:你们以为的定式,其实是错的。

AlphaGo Zero训练36个小时,就超过了击败李世石的那个版本。想象一个人,以前从没下过棋,你只告诉他规则,他没看过一本棋书、一张棋谱,自学36个小时,就能赢李世石。

而且和很多人想象的不同,它下棋时并不靠堆算力,只需要4块TPU。当然,训练阶段它花的算力比AlphaGo多得多。算力花在了「学」上,学会之后,用很少的计算就能下得更好。它是真的更聪明了。

几个月后,团队发现这个围棋AI只要稍加改动,就能学会国际象棋和日本将棋。于是他们把名字里的Go(围棋)去掉了,AlphaZero诞生。

当时最强的国际象棋程序是Stockfish,实力远超当年的深蓝。AlphaZero只训练了9个小时,就以压倒性优势击败了它。Stockfish每秒评估7000万个局面,AlphaZero每秒只看8万个,却赢得非常轻松。(公平起见补一句:两者硬件不同,不好直接比;而Stockfish后来也引入了小型神经网络,如今已经比当年的AlphaZero强得多。)

但棋类毕竟是规则明确的游戏,计算机可以完美地模拟棋盘。现实世界里,我们面对的大多数问题,既不知道明确的规则,也没有完美的模拟器。

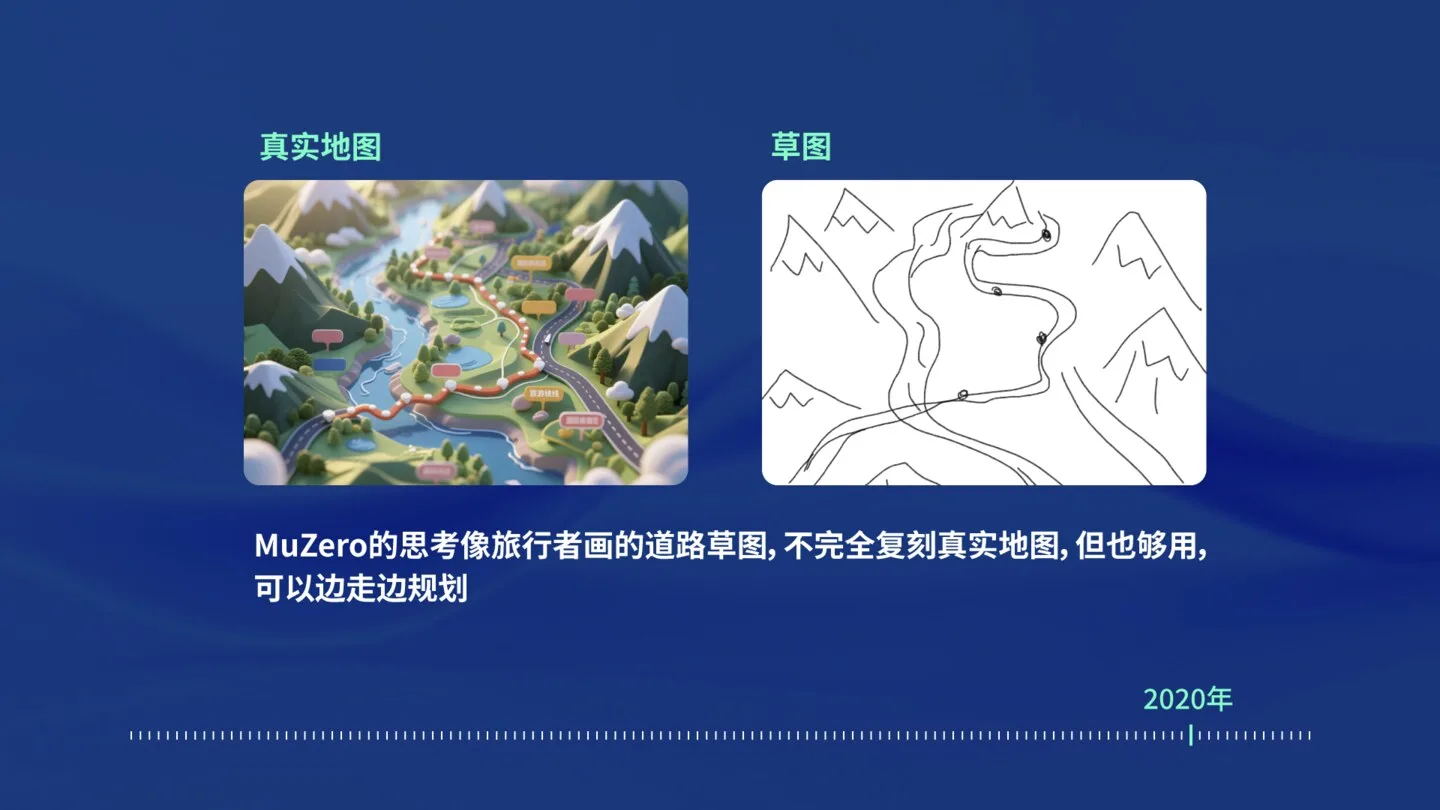
2020年,MuZero回答了这个问题。它不需要知道规则,而是在和环境的交互中,自己学出一张「够用的脑内地图」。

打个比方。一座城市的真实地图非常复杂,但坐地铁时,你只需要一张地铁线路图。线路图的距离、角度、比例尺全是失真的,却保留了换乘需要的全部信息,对坐地铁来说反而更好用。区别在于,地铁图是人画的,而MuZero的地铁图是它自己画的:它只保留对决策有用的那部分。

于是MuZero不光能下棋,还能玩Atari电子游戏,比很多专门为这些游戏设计的程序玩得更好。后来它还被用来给YouTube的视频压缩调节码率,平均节省了约4%的带宽。在YouTube的体量上,这是一个非常大的数字。

金庸在《倚天屠龙记》里写过一段:张三丰演示完太极剑,问张无忌记住了没有。张无忌说忘了一半;再问,说已经全忘了。这时候,他才真正学会了太极剑。

回看AI下棋这条路:

05 这就是大模型正在走的路

现在回到开头那句话:AI只会预测下一个字。

2016年的AlphaGo,起点就是一个「只会预测人类下一步」的模型。如果故事停在那里,它确实注定平庸,最多和KGS上的业余高手一样。但它没有停。

这些年大模型的发展,几乎是把围棋AI的路重走了一遍:

DeepSeek-R1-Zero名字里的Zero,明显就是在致敬AlphaGo Zero。它在训练中还出现了「顿悟时刻」:模型自己学会了停下来、回头检查、换一种思路。

AlphaProof是Google DeepMind的数学证明系统,相关论文2025年11月发表在《自然》上。它有一个特别像人的做法:碰到一道很难的题,它会自己生成几百万道这道题的变体,专门针对这道题再跑一轮学习。就像你遇到难题,先自己出一堆类似的题做一做,把感觉练出来,再回头去攻那道难题。

所以,「预测下一个字」只是起点,不是天花板。AlphaGo只学了业余高手的棋,最后碾压了职业棋手。说大模型「只是在拟合语料,所以注定平庸」,和2015年的我犯的是同一个错误:把起点当成了终点。

其实每一次,人类都在画一条线:

最开始,我们说机器只能又蠢又慢地下棋,704走一步要八分钟。深蓝赢了卡斯帕罗夫,我们说那不过是暴力计算,机器永远不会有直觉。AlphaGo有了直觉,我们说那还是得学人类的棋谱。然后AlphaGo Zero、AlphaZero、MuZero出现,它们开始自己摸索规律,自己定义什么是对的,甚至什么是美的。

每一次,人类都宣称这条线之后是人类专属的领域;每一次,这条线都被轻易跨过。所谓人类的独特性,也许只是更深层次的模式识别而已。

06 为什么是数学和代码先突破

不过,故事到这里还有一个关键的「但是」。

2025年,David Silver和Richard Sutton合写了一篇文章。Silver是AlphaGo的核心作者,也是AlphaProof的作者之一;Sutton是强化学习的奠基人。文章里说得很清楚:AlphaZero、MuZero这样的智能体,能力几乎可以无限扩展,但它们从来没有跨过从模拟到现实的鸿沟。

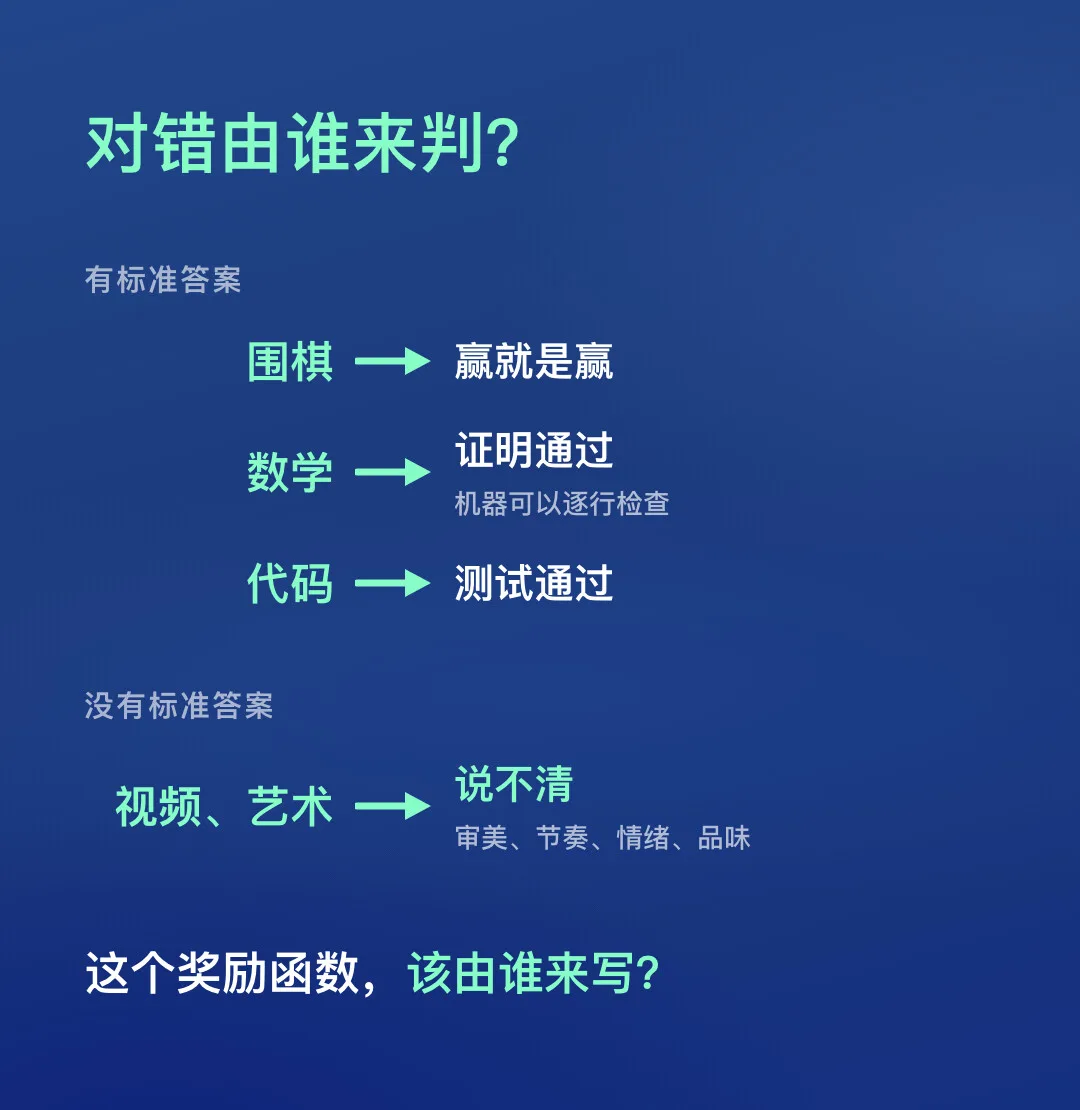
原因在于,围棋也好,数学证明也好,都是目标单一、奖励可以精确定义的问题:赢就是赢,对就是对。而现实世界里,我们面对的更多是开放的、多元的、定义模糊的问题。

这也解释了这一年AI为什么偏偏在数学和代码上突飞猛进:因为这两件事有一个可以验证的对错。OpenAI那份纳维-斯托克斯的证明,同时公开了用形式化语言Lean写成的版本,机器可以逐行检查每一步对不对。棋盘上的「赢」,到了数学里就是「证明通过」。有了可验证的奖励,AlphaGo那一整套自我进化的方法就能派上用场。

那么,那些没有标准答案的事情怎么办?

比如视频。现在AI做视频的能力已经越来越强,可什么叫好视频?审美、节奏、情绪、品味,这个奖励函数,该由谁来写?

最直接的答案是:用人类的标准。但这里有一个很少被讨论的坑,人类的评分偏差是真实存在的。

AlphaGo对李世石的第二局,第37手下出来的时候,现场很多解说都以为是失误。今天我们知道那是好棋,但如果当时让人类给AlphaGo的每一步打分,它会被判定为「不会下棋」。那么在视频、艺术这些领域,会不会也一样?AI可能已经做出了更好的东西,而人类出于无知或偏见设定的标准,反而成了天花板。

反过来,AI自己也有问题。2023年,一位业余棋手借助对抗性的方法,找到了顶级围棋AI的漏洞,用一些人类一眼就能看出问题的招法,把AI骗了,正面赢下了它。之后很多人研究怎么给AI打补丁,可打一个补丁,就冒出一个新漏洞。

这说明,即便AI的平均表现已经远超人类,它在异常情况下也未必可靠。但同样,有人类把关也不等于万事大吉:在这个漏洞被发现之前,职业棋手们照样下不过AI。

所以真正难的问题,不再是「AI能不能」,而是两件事:应该设计怎样的规则,来告诉AI它做得好还是不好;以及,怎样检查AI有没有在钻这套规则的空子。

07 听起来像鸡汤,其实是个硬问题

一年前那场演讲,我是这样结尾的:

我们需要把注意力从「机器能不能」,转向「机器该不该」。直觉和创造力也许不再是人类的专利,但梦想、价值和方向,应该掌握在我们自己手里。如果利用得当,结果就不是AI超越了我们,而是我们一起超越了曾经的自己。

后半句,在围棋上已经应验了。围棋AI出现之后,人类的整体棋力明显上了一个台阶。今天一台普通电脑装上AI,你就拥有了世界上最好的陪练,可以随时高强度对练,学习最前沿的理念。我前段时间写过一篇穿越小说,里面有个判断:今天一个业余高手如果穿越回古代,凭着和AI练出来的棋力和理念,大概能赢下当年的国手。

前半句,在台上说出来,难免听着像一句鸡汤。演讲时间有限,它背后的意思我没来得及展开。

其实「价值和方向握在自己手里」,说的是一个非常具体的技术问题:当AI面对没有标准答案的事情时,奖励函数由谁来定义?用人类的标准,人类会看错;完全交给AI,AI会钻空子。人和AI之间该怎么分工,规则该怎么写,漏洞该怎么查,这些都还没有答案。

棋盘上,人类花了几十年才承认机器也能有直觉。下一条被跨过的线会在哪里,我不知道。但我越来越确定,与其继续争论机器「能不能」,不如认真想想,那条线该由谁来画,又该画在哪里。